
Крупные компании сталкиваются с дилеммой: требования безопасности запрещают отправлять данные во внешние облака, поэтому приходится разворачивать десятки узкоспециализированных нейросетей на собственных серверах. Это приводит к перерасходу дефицитных GPU-мощностей. Исследователи из Т-Банка предложили решение, представленное на конференции уровня A* EMNLP 2026 в Будапеште. Они разработали два метода, которые позволяют значительно снизить стоимость генерации ответов ИИ без потери качества.
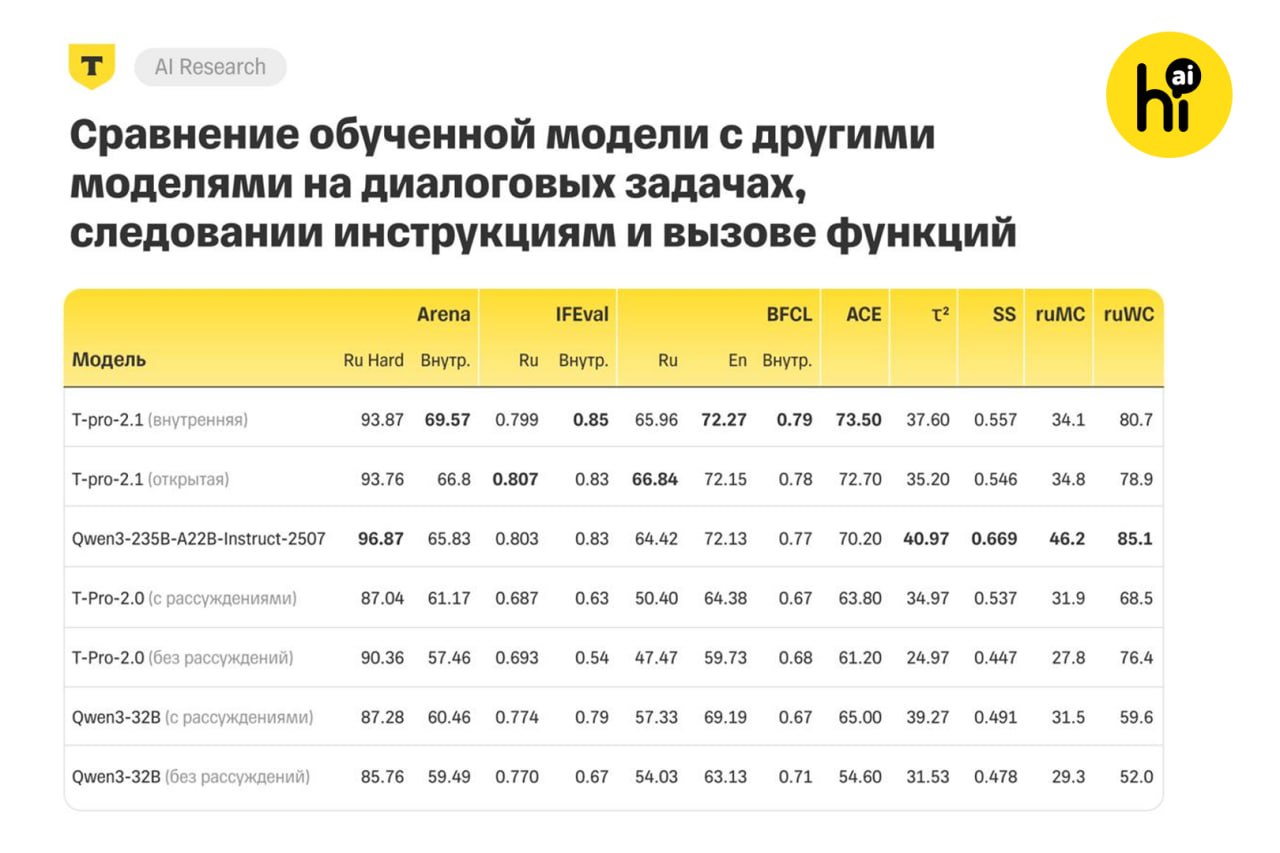
Первый метод — объединение роя узких нейросетей в одну универсальную модель. Команда впервые описала воспроизводимую методику постобучения русскоязычных LLM с агентскими навыками. На базе Qwen3-32B модель сначала дообучили на корпоративных и открытых данных, затем улучшили с помощью обучения с подкреплением по трём направлениям: следование инструкциям, вызов функций и корпоративные задачи. Финальным шагом стало объединение моделей методом SLERP. В результате одна модель на 32 млрд параметров взяла на себя запросы более 200 внутренних сервисов банка и половину трафика его LLM-платформы. Обработка запросов стала в 2,8–3,9 раза дешевле (в отдельных сервисах — до 9 раз) по сравнению с семикратно более тяжёлой Qwen3-235B. При этом на корпоративных тестах компактная версия обошла гиганта: 69,6 балла против 65,8. По следованию инструкциям — 0,85 против 0,83, по вызову функций — 0,79 против 0,77.
Второй метод решает проблему дорогой оцифровки бумажных документов. С помощью пайплайна отбора сложных PDF-примеров исследователи обучили визуально-языковую модель на базе Qwen3.5-35B-A3B-Base извлекать любые реквизиты и суммы по текстовому запросу. При общих 35 млрд параметров модель задействует только 3 млрд на один запрос, а для запуска достаточно одного Nvidia H100. Разбор документов через такую модель обходится на 80% дешевле полностью ручной обработки и на 50% дешевле лучших открытых аналогов.
Исследователи опубликовали методику создания внутренних тестов, описание пайплайна постобучения и саму языковую модель с открытыми весами, обученную на публичных данных. Это позволяет другим компаниям воспроизвести подход и снизить затраты на ИИ-инфраструктуру.


